传统的计划排产软件,标准功能都有,在企业落地时绕不过二次开发。二次开发要补的往往不是算法,而是软件对工厂特殊运营逻辑的理解。在新型的以大模型驱动的计划排产软件中,本体模型将这样的理解进行了系统化。
我们以两个行业的计划排产需求为例,一个是大型电机制造企业,一个是全国性的饮料企业。两个企业都要做「主生产计划」,都要算产能、算物料,可模型建出来之后,除了物料和 BOM,几乎没有一个对象是重合的。
本体的四种积木
所谓本体,是把一家企业的业务世界写成软件读得懂的样子。它有四种积木。
对象,业务里有名字的东西,带着它的属性。一个销售部、一条生产线、一台电机、一个计划版本,都是对象。
关系,对象之间怎么关联。生产线属于哪个工厂,部件装在哪台电机上,哪个工厂有线路通到哪个销售部。
动作,谁可以对对象做什么。提交预测、退回、发布计划、登记产能调整。所有改动都走动作,不允许绕过去直接改数。
语义,业务上怎么称呼它。比如电机厂里「项目」「产品」「设备」「工号」指的可能是同一个东西,饮料厂里「需求计划」和「共识预测」也是。
这四样写清楚,算法知道该算什么,页面知道该展示什么,AI 知道该查什么、能做什么。
两家工厂的世界不一样
把两套模型里最核心的对象画出来,差别一眼就看得见:电机厂的中心是「部件」,饮料厂的中心是「一个数」。
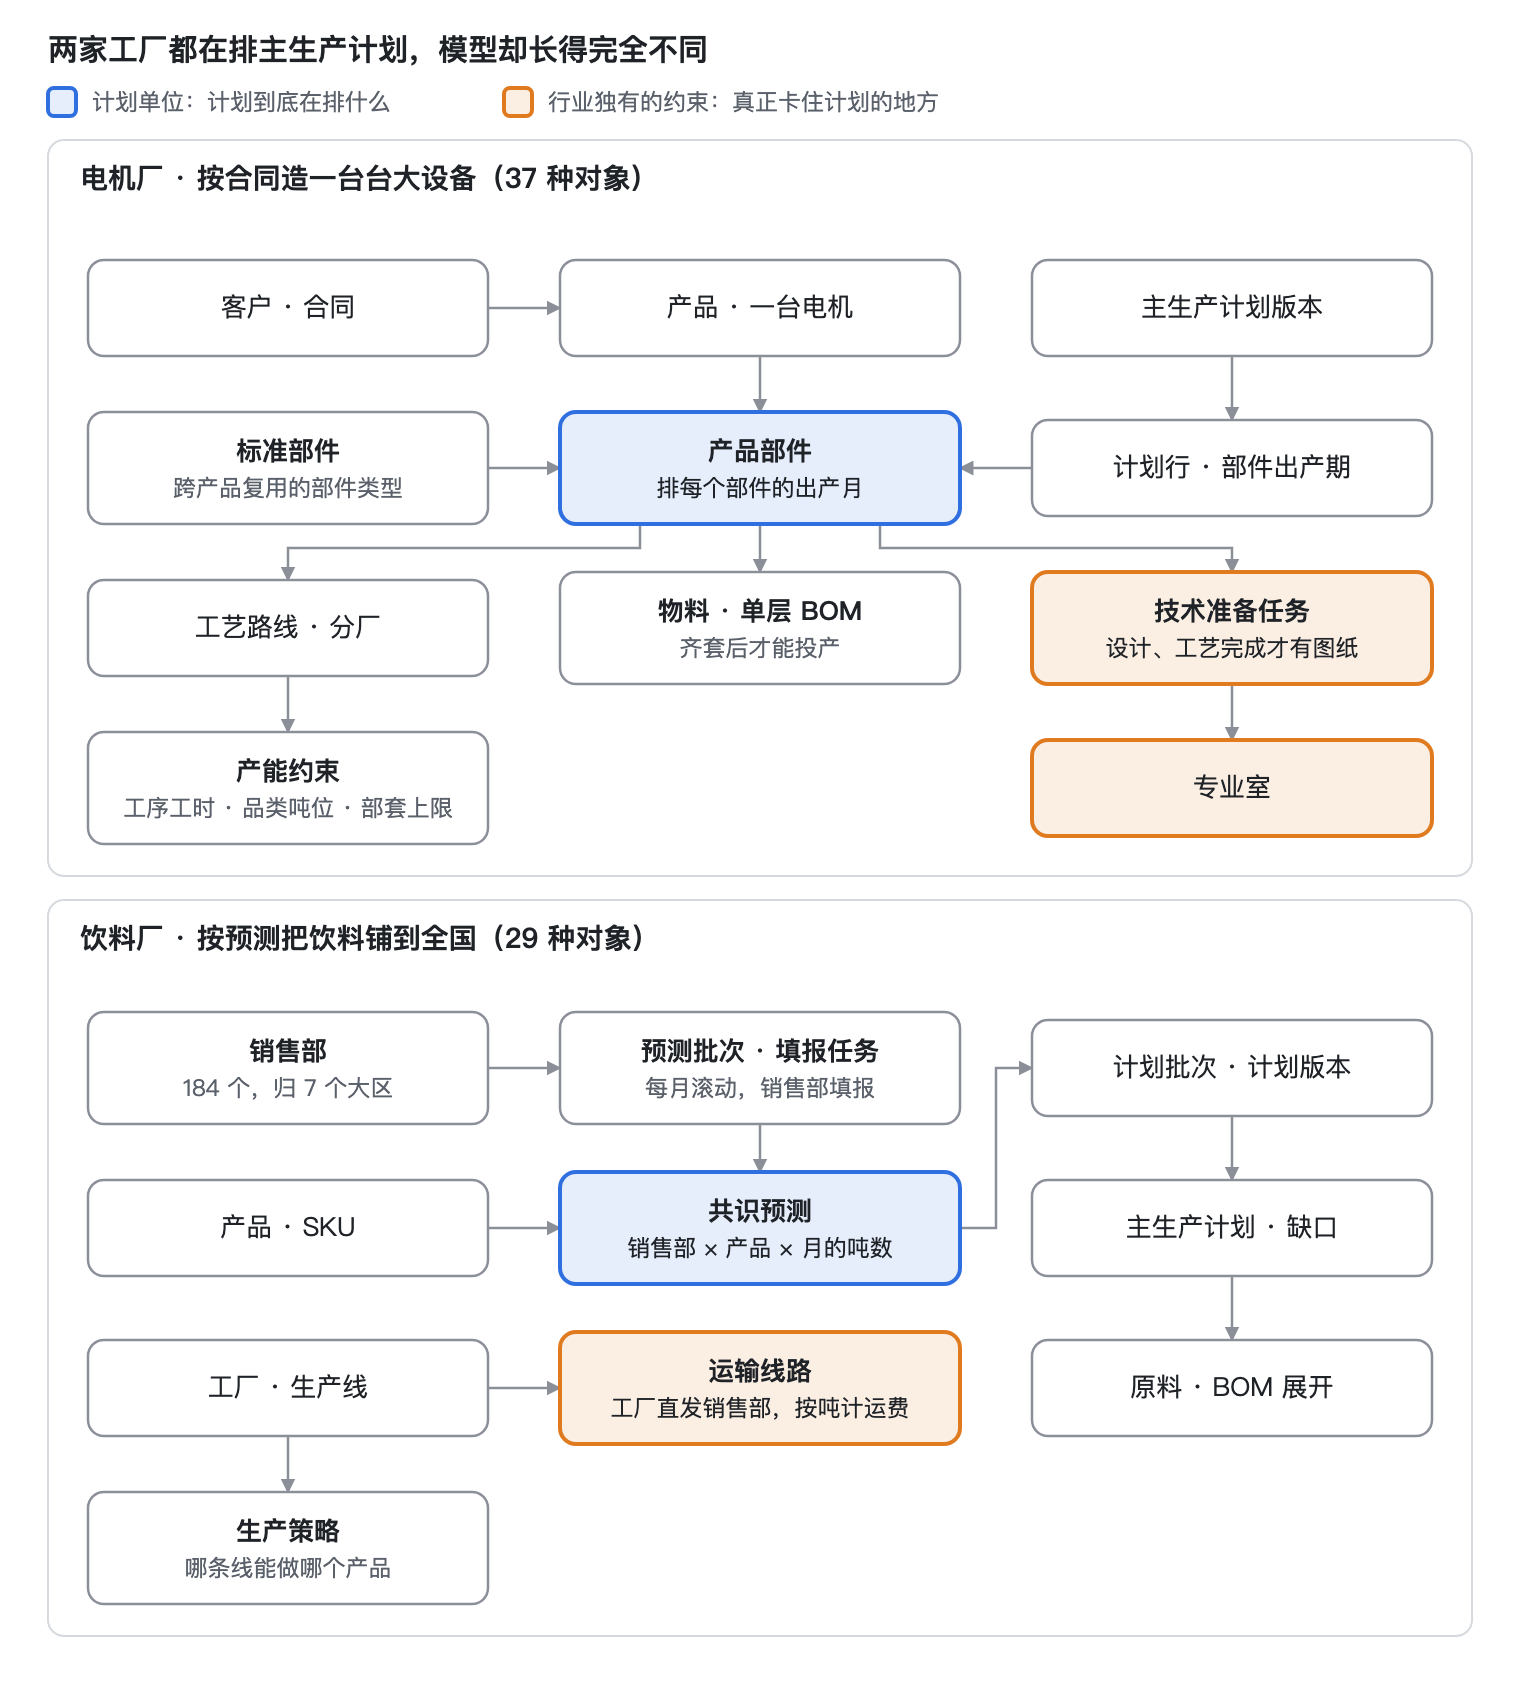
电机企业从合同出发,落到每一个部件,部件再被产能、物料、技术准备三方面制约;饮料集团从销售部的预测出发,落到一个吨数,再由生产线和运输线路去满足它。
业务形态决定模型
两套模型不一样,不是因为做法不同,而是因为两家企业「卖什么、怎么卖」不同。一家按合同造一台一台的大设备,一家按预测把饮料一吨一吨铺到全国。
| 问题 | 电机企业 | 饮料企业 |
|---|---|---|
| 需求从哪里来 | 客户合同,每台有合同交期 | 各个销售部的滚动预测,总部修正后锁定 |
| 计划排的是什么 | 一台电机上的产品部件 | 销售部 × 产品 × 月的吨数 |
| 时间怎么算 | 从合同交期倒推每个部件的需求时间,计划窗口 24 个月 | 下个月起向前看 3 个月,每月滚动一次 |
| 产能卡点 | 内部分厂的关键工序工时、外协厂的品类吨位,还有对某个部套的刚性上限 | 生产线的月工时 |
| 物料 | 部件要等物料齐套才能投产 | BOM 展开得到采购需求,不卡产能 |
| 独有的世界 | 技术准备:设计、工艺、专业室、定标和厂家资料等外部里程碑 | 运输:工厂直发销售部的线路和运费 |
三个差异最能说明问题。
计划的单位不同。电机厂排的是部件,一台电机几百个部件,每个有自己的图号、工艺路线和需求时间。饮料厂排的是数量,某个销售部下个月要多少吨某种饮料。
「产能」在两家企业不是一回事。电机厂的产能有三种计量方式,还要处理「部套」这种可以重叠的逻辑分组;饮料厂只有一种,生产线工时。拿一套通用的「产能表」去套,要么电机厂塞不进去,要么饮料厂一堆空字段。
真正卡住计划的,常常不在生产环节。电机厂的部件经常卡在图纸没出来,所以模型里有一整套技术准备对象;饮料厂的缺货经常是「有产能、运不进去」,所以运输线路必须当一等公民对待。少了这一块,算法算得再精,也是在算一个不存在的工厂。
能复用的骨架
业务对象几乎不重合,但「计划怎么管」这部分骨架完全一样。这是可以做成框架、不必每次重写的东西。
计划是版本,不是一张表。两边都把计划建成「版本」对象:先算、再比、发布一个版本去执行,旧版本归档但能恢复。同一时间只有一个执行中的版本。
改数只走动作。不管是页面上点按钮、接口调用还是 AI 智能体,写数据都经过同一组动作,角色和业务规则在动作里检查。
原始值和修正值都留着。饮料集团里销售部的上报、计划员的每次修正各有对象;电机企业在计划发布时会把当时的结果存成快照。审计不是事后找补,而是模型里本来就有。
共性用接口描述。饮料集团很多对象「按产品」「按销售部」「按月」,电机企业很多对象「属于某台产品」「可审批」「可追溯」。把这些共性声明出来,筛选、汇总、权限就能统一做。
所以说,行业差异是在「世界长什么样」,而「计划怎么被提出、审核、发布、追责」是共通的。这也是我们把框架和应用分开的原因。
建模的五条实战原则
- 从决策倒推,不要从数据表出发。先问计划员每天做什么决定,再问做这个决定要看什么。系统里有的表,不一定都要进模型。
- 用业务的话命名。对象叫「产品部件」「部套」「销售部」,不叫「物品」「分组」「节点」。一个东西有几种叫法,就都登记成术语,让人和 AI 都能找得到。
- 把看不见的约束挖出来。老计划员脑子里那些「这个要等定标」「那个厂发不到东北」,往往才是最重要的对象。电机企业的技术准备规则就是这么找出来的。
- 描述写进模型里。每个对象用一两句话说清它是什么、和谁不一样。比如电机企业的「部套」是部件的逻辑组合,用于归类和产能约束,不是排产单元,也不是 BOM 上的父子层级,部套之间可以重叠。这段话既是给人看的文档,也是给 AI 看的说明书。
- 先跑通,再长全。第一版模型只要能跑通一个真实的计划周期就够。电机企业的模型是在一个个例外里生长出来的:物料延迟、紧急插单、技术准备异常,每碰到一种,就加一个对象或一个动作。
没有本体,大模型做不了计划
大模型会说话,但它不认识你的企业。接到计划系统上,本体做了三件事。
告诉它世界长什么样。对象和关系的描述就是它的入职培训。我们在饮料应用里问过智能体:「七台河销售部的晶纯软化水为什么缺货?」它顺着销售部 → 运输线路 → 生产线一路查下去,答案是:七台河只有一个工厂有直发线路,而那儿的产线已经满负荷;十条有空闲的产线,都没有线路通到那里。同一个问题放到电机厂,它会顺着产品 → 部件 → 产能、物料、技术准备去查。路径不同,因为本体不同。
给它一组安全的手。智能体不能直接改数据,只能提议执行本体里定义好的动作:生成一个计划场景、发布一个版本、退回一份上报。动作里有角色检查和业务规则,每一个都能回滚。自动执行还是等人审批,由计划员设的阈值决定。
让数字有出处。大模型不算数。每个方案的满足率、缺口、成本,都是它调用代码、在本体数据上让算法引擎试算出来的。它负责的是查找、对比、解释、推荐。
所以企业要用好 AI,第一步不是挑哪个大模型,而是把自己的业务建模清楚。算法模型可以换,但本体是你自己的。